1. 题目含义
根据 LeetGPU 题目原文,给定行优先存储的 float 矩阵 和 ,计算 :
三个矩阵的一维地址分别为 A[m*N+n]、B[n*K+k] 和 C[m*K+k]。题目约束 1 ≤ M,N,K ≤ 8192,性能测量规模是 M=8192, N=6144, K=4096。
题目的两个样例如下,可以进行手算核对:
示例 1:M=2, N=2, K=2
A = [1 2; 3 4], B = [5 6; 7 8], C = [19 22; 43 50]

示例 2:M=1, N=3, K=1
A = [1 2 3], B = [4; 5; 6], C = [32]
2. 题目的规模和性能边界
按一次乘法和一次加法各算一次浮点运算,计算量约为 。在题目指定规模下是 412,316,860,416 FLOP,约 0.4123 TFLOP。A、B、C 分别占 192 MiB、96 MiB、128 MiB,三者合计 416 MiB。这些是矩阵本身的大小;它们不等于实际 DRAM 流量。
理想情况下只把 A、B 各从 DRAM 读一次、把 C 写一次,对应 416 MiB 的数据移动下界(不计缓存写策略等额外流量)。朴素源码表面上每个输出要读取 N 个 A 元素与 N 个 B 元素,但缓存可以消除部分重复的 DRAM 读取。
3. V1 最简单直接的方案:一个线程算一个输出
推导与代码
二维 Grid 中,threadIdx.y 对应输出行,threadIdx.x 对应输出列。每个有效线程从 n=0 累加到 N-1,最后只写一次 C[row*K+col]。越界线程在读取矩阵前返回,因此每个合法输出只会由一个线程写入。相邻 x 线程写相邻的 C 列,读取 B[n*K+col] 也沿列连续;同一行的 A[row*N+n] 则在这些线程间重复使用。
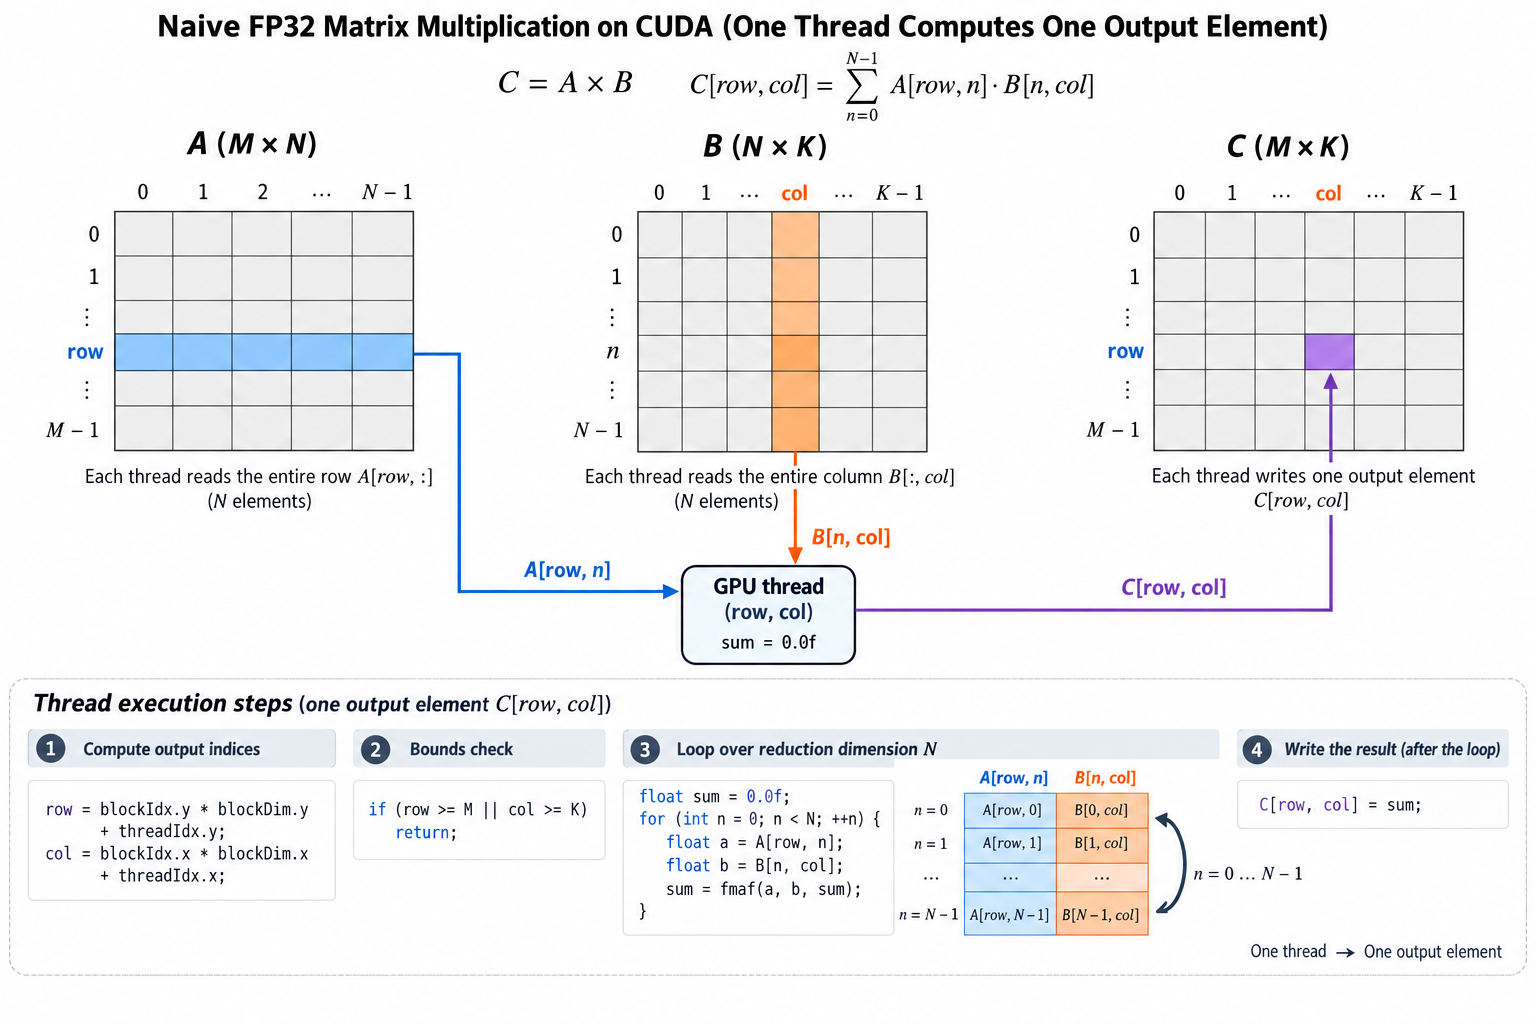 按图写代码时,可以从紫色的一个输出格反推输入:
- 定位输出格。
row = blockIdx.y*blockDim.y + threadIdx.y,col = blockIdx.x*blockDim.x + threadIdx.x。一个线程固定负责C[row,col]。 - 排除无效线程。 图中矩阵尺寸是
M×K;当row>=M或col>=K时直接返回。输出列的边界是K,不是归约长度N。 - 找出输入。 蓝色是
A的第row行,橙色是B的第col列。相同的n选出一对元素:A[row*N+n]和B[n*K+col]。 - 沿归约维计算。
n遍历0…N-1,sum从0.0f开始,并在寄存器中反复做fmaf(A[...], B[...], sum)。图中的乘加式表示同一步骤;代码使用融合乘加。 - 写回。 整个循环结束后,才将
sum写入C[row*K+col]。因此不需要先清零 Device 上的C。 所以当前的kernel实现为
// LeetGPU notation: A is M x N, B is N x K, C is M x K.
__global__ void matmul_naive(const float* A, const float* B, float* C,
                             int M, int N, int K) {
    const int row = blockIdx.y * blockDim.y + threadIdx.y;
    const int col = blockIdx.x * blockDim.x + threadIdx.x;
    if (row >= M || col >= K) return;

    float sum = 0.0f;
    for (int n = 0; n < N; ++n) {
        sum = fmaf(A[row * N + n], B[n * K + col], sum);
    }
    C[row * K + col] = sum;
}
所以当前在网站执行的结果是:
Spinning up A100-80GB...
Running...
A = [[1.0, 2.0], [3.0, 4.0]]
B = [[5.0, 6.0], [7.0, 8.0]]
M = 2
N = 2
K = 2
✓ Test passed
笔记!
- 这里的每个线程计算一个数据,主要是需要正确计算
A和B矩阵的一维地址,这部分内容参考PMPP书上的内容来对应按照行优先的方式映射即可; - 这个实现中,
A和B矩阵中部分元素会被重复读取,下一个版本可以考虑复用这部分内容。
4. V2:Shared Memory 分块
从输出块反推输入块
令一个 Block 计算 个输出。把归约维 N 分成长度为 16 的区间;每轮协作加载 的 16×16 子块和 的 16×16 子块。加载后全 Block 同步,确保所有元素可读;完成本轮乘累加后再同步,确保没有线程在别的线程读旧 tile 时覆盖 Shared Memory。这里__syncthreads() 只作用于同一个 Block,不能跨 Block 同步。NVIDIA CUDA Programming Guide:Shared Memory 与同步
尾块可能同时遇到 M、N 或 K 越界。加载时给越界位置填零;所有线程仍须经过两次同步,最后再由合法线程写回。这样 M=1,N=1,K=1 和 17×19×31 等非整块输入也有定义。NVIDIA 的 Best Practices Guide 矩阵乘法示例使用 Shared Memory 说明跨线程复用;此处的边界处理和代码是针对本题形状编写的。
其实这部分内容也在PMPP上有讲过,也有代码,主要内容在chapter 5中,分块的思路如下图所示:
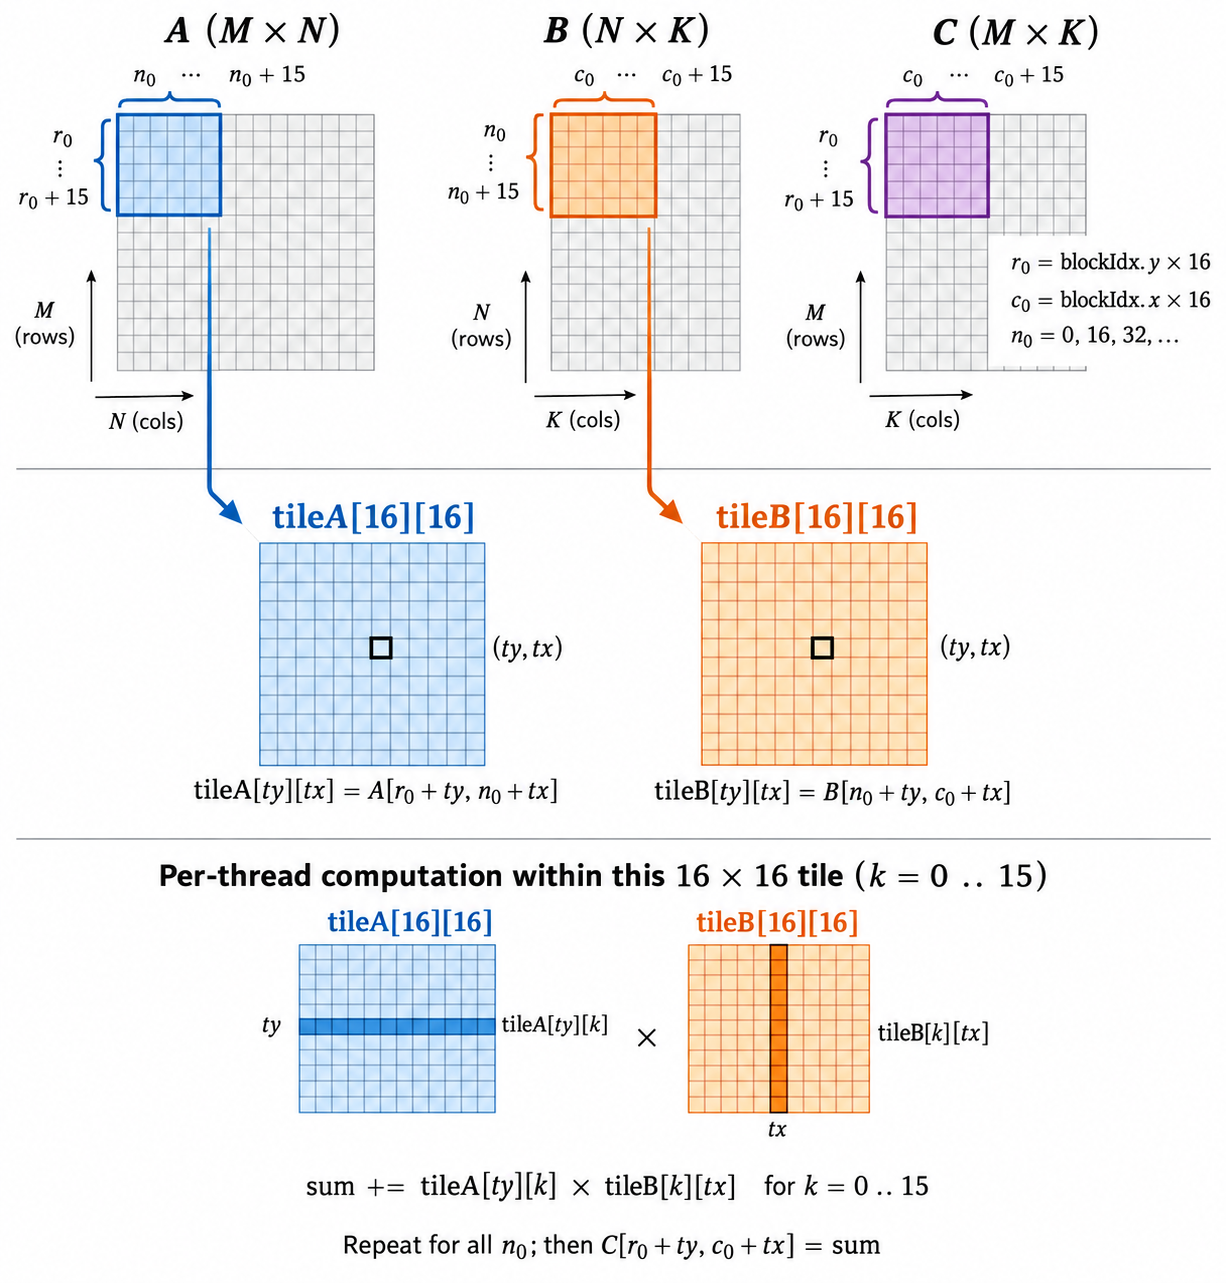 图中的
r0=blockIdx.y*16、c0=blockIdx.x*16,所以当前线程负责 row=r0+ty、col=c0+tx。n0 沿归约维每次移动 16 个元素。图上每个颜色框代表本轮的区域,不是整个矩阵的最终结果。
- 每个线程将
A[row,n0+tx]放到tileA[ty][tx],将B[n0+ty,col]放到tileB[ty][tx]。图中黑框标出同一个(ty,tx)线程写的两个 Shared Memory 格子。 - 越过
M、N或K边界时,加载目标格子仍须写0.0f,避免随后读到未初始化的 tile 内容。此时线程不能提前退出,因为所有线程都要到达同步屏障。 - 第一次
__syncthreads()保证本轮两个 tile 都已写好。随后,线程从蓝色的tileA[ty][k]横行和橙色的tileB[k][tx]竖列各取一个元素,按k=0…15累加到自己的sum。 - 第二次
__syncthreads()保证其他线程已经读完旧 tile,才能开始下一轮n0并覆盖 Shared Memory。所有n0轮结束后,合法线程才写C[row,col]。
尾块可能同时遇到 M、N 或 K 越界。加载时给越界位置填零;所有线程仍须经过两次同步,最后再由合法线程写回。这样 M=1,N=1,K=1 和 17×19×31 等非整块输入也有定义。NVIDIA 的 Best Practices Guide 矩阵乘法示例使用 Shared Memory 说明跨线程复用;此处的边界处理和代码是针对本题形状编写的。
所以当前的代码实现:
// v2
const int TILE = 16;

__global__ void matrix_multiplication_kernel(const float* A, const float* B, float* C, int M, int N, int K)
{
    // 首先创建共享内存数组
    __shared__ float tileA[TILE][TILE];
    __shared__ float tileB[TILE][TILE];

    // 计算出对应的坐标
    const int tx = threadIdx.x;
    const int ty = threadIdx.y;
    const int row = blockIdx.y * TILE + ty;
    const int col = blockIdx.x * TILE + tx;

    float sum = 0.0f;

    for (int n0 = 0; n0 < N; n0 += TILE)
    {
        // 现在需要计算加载到共享内存中的元素位置的坐标
        const int aCol = tx + n0;
        const int bRow = ty + n0;

        tileA[ty][tx] = (row < M && aCol < N) ? A[row * N + aCol] : 0.0f;
        tileB[ty][tx] = (bRow < N && col < K) ? B[bRow * K + col] : 0.0f;

        // 同步屏障
        __syncthreads();

        // 现在开始计算一行一列的乘积
        for (int k = 0; k < TILE; ++k)
        {
            sum = fmaf(tileA[ty][k], tileB[k][tx], sum);
        }
        __syncthreads();
    }

    if (row < M && col < K)
    {
        C[row * K + col] = sum;
    }
}
一个完整的 16×16×16 子问题大约做 8192 FLOP,从 Global Memory 显式加载 512 个 float,即 2048 字节;只按这些加载计,计算量与加载字节之比为 4 FLOP/byte。
5. V3:一个线程在寄存器中算四个输出
再提高每次加载的使用次数
一个 Block 现在覆盖 16×64 个 C 元素,线程布局仍为 16×16。每个线程负责同一行上的四列:col0、col0+16、col0+32、col0+48。同一个 A[row,n] 被用于这四个累加器,所以每线程保存四个 float 结果;B tile 扩展为 16×64。B 的每组 16 列仍由连续的 x 线程加载。
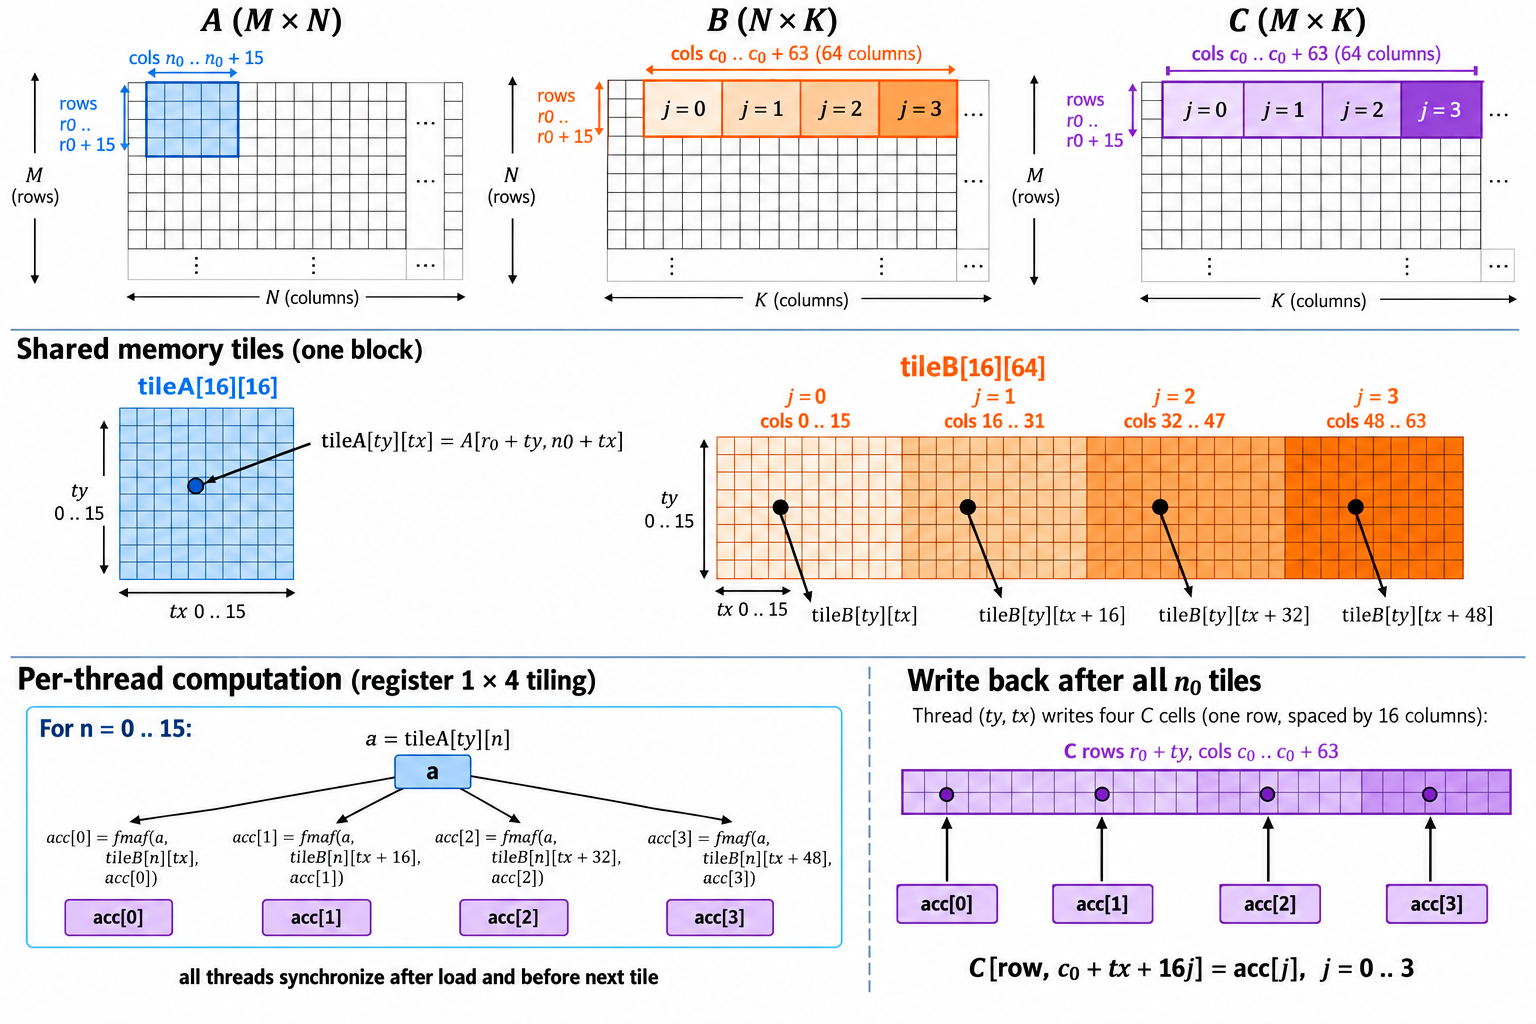 图中
r0=blockIdx.y*16、c0=blockIdx.x*64。同一个 Block 的 256 个线程仍按 16×16 排列,但覆盖的输出区域已扩为 16×64。对选中的 (ty,tx) 线程,代码和图可以这样对应:
row=r0+ty,col0=c0+tx;四个输出列为col0+16*j,其中j=0,1,2,3。这四列相隔 16,不是四个相邻列。- 在每轮
n0中,线程只加载一个A[row,n0+tx]到tileA[ty][tx],再从B的四个 16 列子区各加载一个元素到tileB[ty][tx+16*j]。若源坐标越界,就写零到相应 Shared Memory 格子。 - 第一次
__syncthreads()后,线程在每个n=0…15读取同一个a=tileA[ty][n],分别与tileB[n][tx+16*j]相乘并累加到acc[j]。图中由同一个蓝色a分出的四条线对应这四次fmaf。 - 第二次
__syncthreads()后进入下一轮n0。所有归约轮次结束,才把四个累加器分别写到C[row*K+col0+16*j];每次写入单独检查列是否小于K。
// v3
constexpr int TILE_M = 16;
constexpr int TILE_REDUCTION = 16;
constexpr int TILE_COLS = 64;


__global__ void matrix_multiplication_kernel(const float* A, const float* B, float* C, int M, int N, int K)
{
    // 定义共享数组
    __shared__ float tileA[TILE_M][TILE_REDUCTION];
    __shared__ float tileB[TILE_REDUCTION][TILE_COLS];

    const int ty = threadIdx.y;
    const int tx = threadIdx.x;
    const int row = blockIdx.y * TILE_M + ty;
    const int col = blockIdx.x * TILE_COLS + tx;

    // 定义一个包含四个元素的数组,用来直接一次性计算四个元素
    float acc[4] = {0.0f, 0.0f, 0.0f, 0.0f};

    for (int n0 = 0; n0 < N; n0 += TILE_REDUCTION)
    {
        const int aCol = n0 + tx;
        const int bRow = n0 + ty;
        tileA[ty][tx] = (row < M && aCol < N) ? A[row * N + aCol] : 0.0f;
        for (int j = 0; j < 4; ++j)
        {
            const int col_b = col + j * 16;     // 这是计算第几个块的列
            tileB[ty][tx + j * 16] = (bRow < N && col < K) ? B[bRow * K + col] : 0.0f;
        }

        __syncthreads();

        // 现在开始计算
        for (int n = 0; n < TILE_REDUCTION; n++)
        {
            const float a = tileA[ty][n];
            for (int j = 0; j < 4; ++j)
            {
                acc[j] = fmaf(a, tileB[n][tx + j * 16], acc[j]);
            }
        }
        __syncthreads();
    }

    // 现在收尾
    if (row < M)
    {
        for (int j = 0; j < 4; ++j)
        {
            const int col_in = col + j * 16;
            if (col_in < K)
            {
                C[row * K + col_in] = acc[j];
            }
        }
    }
}
一个完整的 16×64×16 子问题约做 32768 FLOP,源码加载 16×16 + 16×64 = 1280 个 float,即 5120 字节;只按这些加载计,计算量与加载字节之比为 6.4 FLOP/byte。更高的数据复用需要更多 Shared Memory 和寄存器,可能影响 Occupancy 或增加指令开销。
6. 代码和资料
这部分内容主要参考以下资料: